Anurag Renduchintala*, Adi Mahesh*, 张紫宸*, Zimo Si*, Shangjun Meng*, Samuel Fang*.
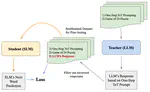
ToT 通过探索多条路径并回溯来解决复杂推理问题,但反复调用模型,成本高,也不适合小模型。我们把它压成一个结构化提示,再把
GPT-4o 的输出蒸馏到
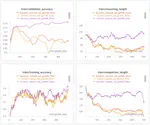
SmolLM-360M。在 24 点任务中,单步 ToT 的准确率为 19%,思维链为 7%;用 144 条样本微调后,SmolLM 从 1% 提升到 9%。完整的 GPT-4o 多步 ToT 达到 82%,高于此前 GPT-4 的 74%。